Iemand van het management stelt een terechte vraag, dus krijgt de scorecard een kolom voor haalbaarheid. Een jaar later staat er werk op de goedgekeurde lijst dat het team ook zonder die kolom had kunnen bouwen.
De symptomen zijn goed herkenbaar:
- Gedurfde inzendingen blijven steken bij de verrijking en verlopen stilletjes.
- Scoresessies veranderen in discussies over wie volgend kwartaal capaciteit heeft.
- Het portfolio vult zich met voorzichtige uitbreidingen van wat al werkt.
- Geen enkel overleg verklaart waar de ambitie is gebleven.
Haalbaarheid hoort thuis op elke scorecard die bepaalt waar het geld heen gaat. Zonder die kolom vult de shortlist zich met werk dat niemand kan bemensen.
De schade komt voort uit de manier waarop kaders worden toegevoegd, niet uit het hebben ervan. Welke absoluut zijn, waar ze binnenkomen, wat het getal meet, hoe fijnmazig het wordt gescoord.
Vier scorecardbeslissingen regelen dat. Doe je het goed, dan wint de veilige optie niet langer standaard – doe je het fout, dan verandert er weinig.
Waarom een haalbaarheidskolom stilletjes voor de veilige optie kiest
De ideeselectiefase gedraagt zich anders dan het genereren van ideeën. De experimentele literatuur over hoe mensen kiezen is weinig vleiend.
Selecteurs grijpen naar wat haalbaar is
Een studie uit 2010 over ideeselectie beschrijft “the strong tendency … to select feasible and desirable ideas, at the cost of originality.”
Selecteurs opdragen om creativiteit voorop te stellen veranderde wat zij kozen. Het verlaagde ook de tevredenheid en de beoordeelde effectiviteit van hun keuzes (de effectiviteit-originaliteitsafweging van de auteurs).
De haalbaarheidskolom is de plek waar die neiging procedureel wordt:
- Een voorkeur die niemand hoeft te verdedigen krijgt een eigen vakje op het formulier.
- Het vakje krijgt een weging, en de weging krijgt een getal.
- Het getal wordt gemiddeld, gerapporteerd en gelezen alsof het een meting was.
Je voelt die neiging in de zaal lang voordat iemand het hardop zegt. Tegen die tijd is het rekenwerk, en discussiëren erover betekent discussiëren met het formulier.
Een eerder experiment uit 2006 van hetzelfde team vond dat ideeselectie “was not significantly better than chance.”
Die 2 resultaten zeggen verschillende dingen en horen niet op elkaar gestapeld te worden. Het ene gaat over nauwkeurigheid op kansniveau, het andere over een richtingsvoorkeur.
Niets hiervan pleit ervoor om haalbaarheid helemaal te schrappen. De ontwerpvraag is het punt waarop dat oordeel mag meespelen.
Waar expliciete criteria het beeld veranderen
Amabile’s experiment uit 1979 liet studenten kunstwerken maken onder verwachte beoordeling. Juryleden beoordeelden dat werk significant lager op creativiteit.
Eén groep ontsnapte eraan, namelijk de deelnemers die expliciet te horen kregen hoe je werk maakt dat als creatief beoordeeld wordt. Ondoorzichtige criteria lijken de schade aan te richten, en de jouwe publiceren kan 3 dingen doen:
- Het giswerk over wat beoordelaars willen verminderen.
- Je vrijheid wegnemen om halverwege de cyclus de doelpalen te verzetten.
- Indieners laten zien welke onzekerheden ze moeten benoemen en welke diskwalificeren.
De rubric fungeert daarmee ook als briefing voor de mensen die indienen. Hij beschrijft wat er gefinancierd wordt, in de woorden die jij hebt gekozen.
Bijdragers lezen hem als een beschrijving van wat gefinancierd wordt, en een slordig geschreven rubric levert zorgvuldig onambitieuze ideeën op.
Die uitzondering weegt hier zwaar. Het gaat om één conditie in één studie, dus een gepubliceerde rubric is een redelijke gok, geen bewezen oplossing.
Wat het onderzoek werkelijk zegt over kaders
Kaders hebben in het onderzoek een betere reputatie dan in de scoresessie. Het bewijs ondersteunt geen simpel goed-of-slechtoordeel.
Een review uit 2019 in het Journal of Management rapporteert een omgekeerde U tussen kaders en creativiteit. Te weinig onderdrukt haar, en te veel doet hetzelfde.
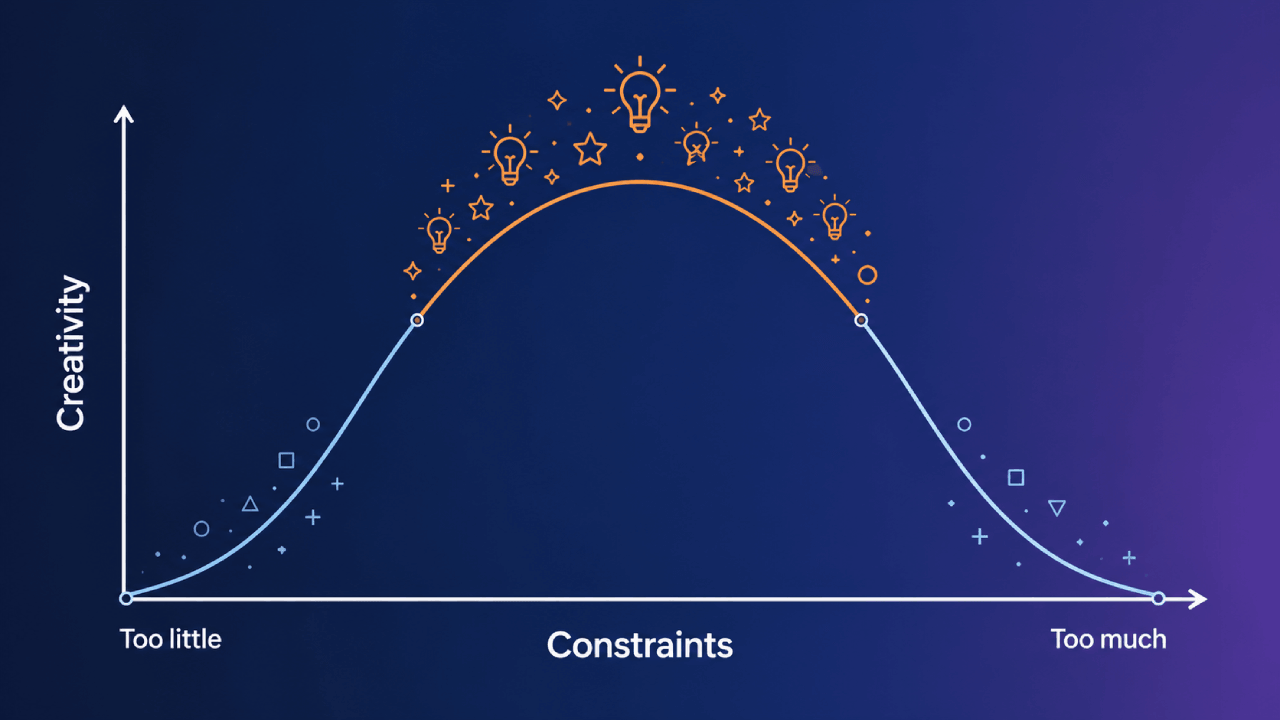
Om eerlijk te zijn is dat een synthese van ander werk, dus het geeft een vorm zonder een kalibreerbaar omslagpunt. Zo ziet één toepassing op scorecardontwerp eruit:
| Hoe de scorecard is ingesteld | Hoe dat er in de praktijk uitziet | Wat er met de ideeënvijver kan gebeuren |
|---|---|---|
| Weinig gestelde grenzen | Geen absolute eisen, open scoring | Onbouwbare inzendingen, geen gedeelde standaard |
| Een handvol absolute eisen | Een korte must-meetlijst, grove niveaus | Ambitieuze ideeën komen nog steeds door de intake |
| Een lange must-meetlijst | Veel must-meets, fijnmazige scoring | Veilige varianten op het huidige werk |
In Haught-Tromps rijmstudies uit 2017 werden gebonden verzen als creatiever beoordeeld dan ongebonden verzen. De gemiddelden waren 5,18 tegenover 4,29 in studie één en 5,13 tegenover 4,36 in studie twee.
Haught-Tromp vond ook een overdrachtseffect, waarbij oefening onder een kader de creativiteit in latere ongebonden opdrachten verhoogde. Het is een rijmtaak, dus lees de overdracht naar creatieve praktijk beperkt.
Rosso’s veldstudie uit 2014 onder vier R&D-teams zag kaders sommige teams helpen en andere afremmen.
Het verschil zat in de vraag of de omringende dynamiek stimulerend was. Pas je dat mechanisme toe op scorecards, dan kan een must-meetlijst in verschillende teams anders uitpakken.
Scheid harde kaders van gescoorde haalbaarheid
Cooper en Edgetts artikel uit 2006 merkt op dat gate-scorecards “can include must-meet (mandatory) as well as should-meet (desirable) criteria.” Beide in één kolom stoppen is waar het misgaat.
| Type criterium | Welke vraag het beantwoordt | Wie hem beantwoordt | Wat een “nee” betekent | Waar het in de funnel zit |
|---|---|---|---|---|
| Hard kader | Kunnen we dit überhaupt doen? | Legal, security of de eigenaar van de strategie | Het idee stopt, wat het verder ook scoort | Bij de intake, vóór het scoren |
| Gescoord criterium | Hoe duur is het om erachter te komen? | Het beoordelingspanel | Een lagere score, geen automatische uitsluiting | Na de verrijking, vóór financiering |
Must-meetcriteria zijn binair, zonder enige gedeeltelijke score. Ze worden vóór alle scoring gecontroleerd, zodat ze een getal niet kunnen besmetten.
Wel, die volgorde is precies het punt. Een hard kader dat ná het scoren wordt toegepast wordt een laat veto over een optie die nooit in aanmerking kwam.
De toets voor een hard kader
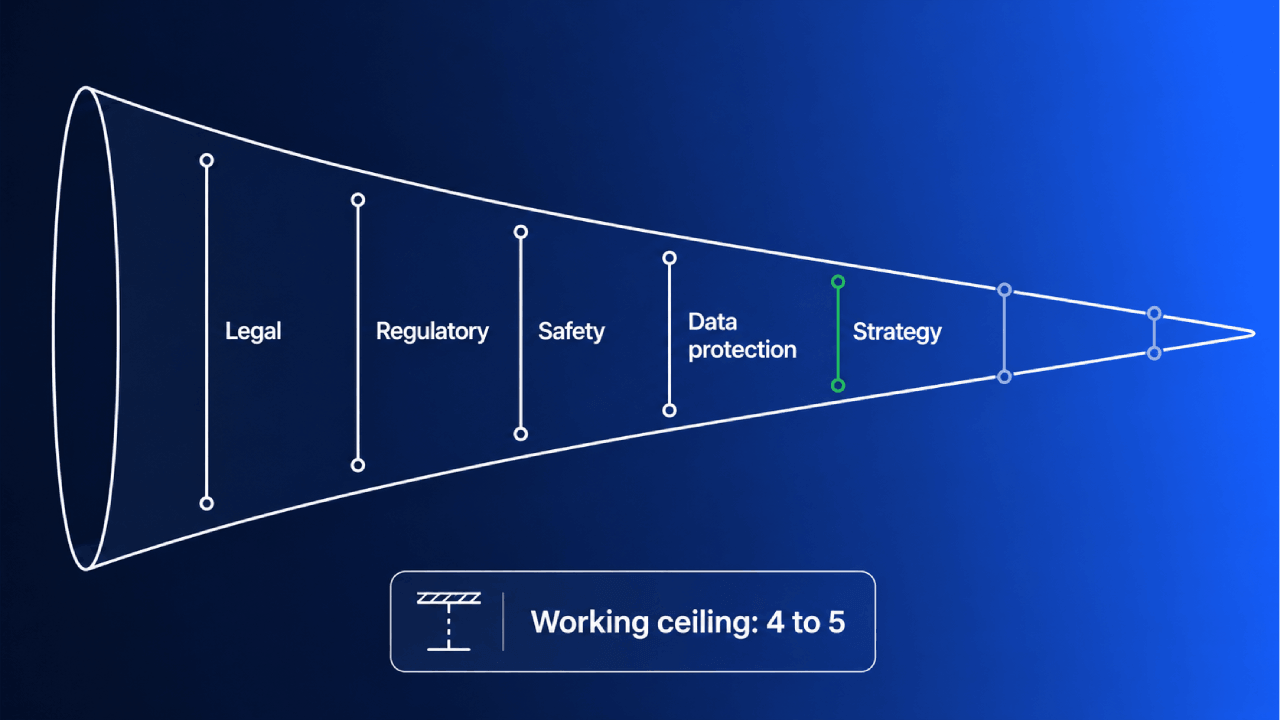
Voor innovatierisico reserveer je harde kaders voor juridische, regelgevende, veiligheids-, gegevensbeschermings- of strategische eisen die het gesprek echt beëindigen.
De toets is hier bot: als een “nee” bespreekbaar is, is het geen hard kader en hoort het thuis in de scoring.
Waarom de lijst niet moet groeien
Gebruik 4 of 5 harde kaders als werkbaar plafond. Elk extra kader vernauwt de funnel voordat iemand het idee heeft gelezen.
Cooper en Edgett zijn ook nuttig over wat er stroomafwaarts gebeurt. Zodra een project begint, schrijven zij, “there is very little chance that it will ever be killed.”
Hun artikel geeft geen gekwantificeerd verspillingscijfer, dus behandel dat als richtinggevend. Het verklaart wel waarom stopcriteria stroomopwaarts van elke echte toezegging horen.
Scoor de kosten van uitzoeken, niet de kans op succes
Vroege haalbaarheidsscores zijn voorspellingen over werk dat nog niet volledig is uitgewerkt. Boehms cone of uncertainty legt de marge op ruwweg 0,25x tot 4x in de haalbaarheidsfase.
Die versmalt tot ongeveer 0,67x tot 1,5x bij de requirementsspecificatie, in Boehms eigen herformulering uit 2013. Daar volgen drie dingen uit:
- Een score bij de intake is een voorspelling van een voorspelling.
- Een tienpuntsschaal suggereert een zekerheid die die marge niet kan dragen.
- Richting en ruwe grootteorde houden stand, en niets fijnmaziger dan dat.
De schattingen komen uit softwarewerk, dus de overdracht naar ander vroeg werk is een aanname.
De precisie verbetert naarmate het werk in detail wordt gespecificeerd. Tot die tijd belooft de schaal meer dan het bewijs waarmaakt.
Niets daarvan maakt een vroege schatting nutteloos. Het maakt de schaal waarop je hem vastlegt tot het ding dat je goed moet krijgen.
Wanneer vroege schattingen te optimistisch zijn
Optimisme in vroege schattingen is ruim buiten innovatieportfolio’s gedocumenteerd. Een studie uit 2003 van 258 transportprojecten in 20 landen rapporteerde de gemiddelde overschrijding per projecttype:
| Projecttype | Gemiddelde kostenoverschrijding |
|---|---|
| Spoor | 45% |
| Vaste oeververbindingen | 34% |
| Wegen | 20% |
De auteurs concluderen dat kostenoverschrijding “is the rule rather than the exception.” Dat is transportinfrastructuur, hier geleend als analogie.
Hoe groot het effect binnen een bedrijfsportfolio wordt is onbekend. De richting is wat overdraagbaar is, en die pleit ertegen om een scorecard om kansen te vragen.
Kansen op succes maken plaats voor de kosten van uitzoeken, en voor snelheid. Op haalbaarheid hoort een test van 3 weken hoger te scoren dan een zelfverzekerde gok.
McGrath en MacMillans discovery-driven planning uit 1995 opent met grote verliezen in onbekend terrein, Disney’s Europese park boven $1B in 1994 en FedEx’ Zapmail op $600M.
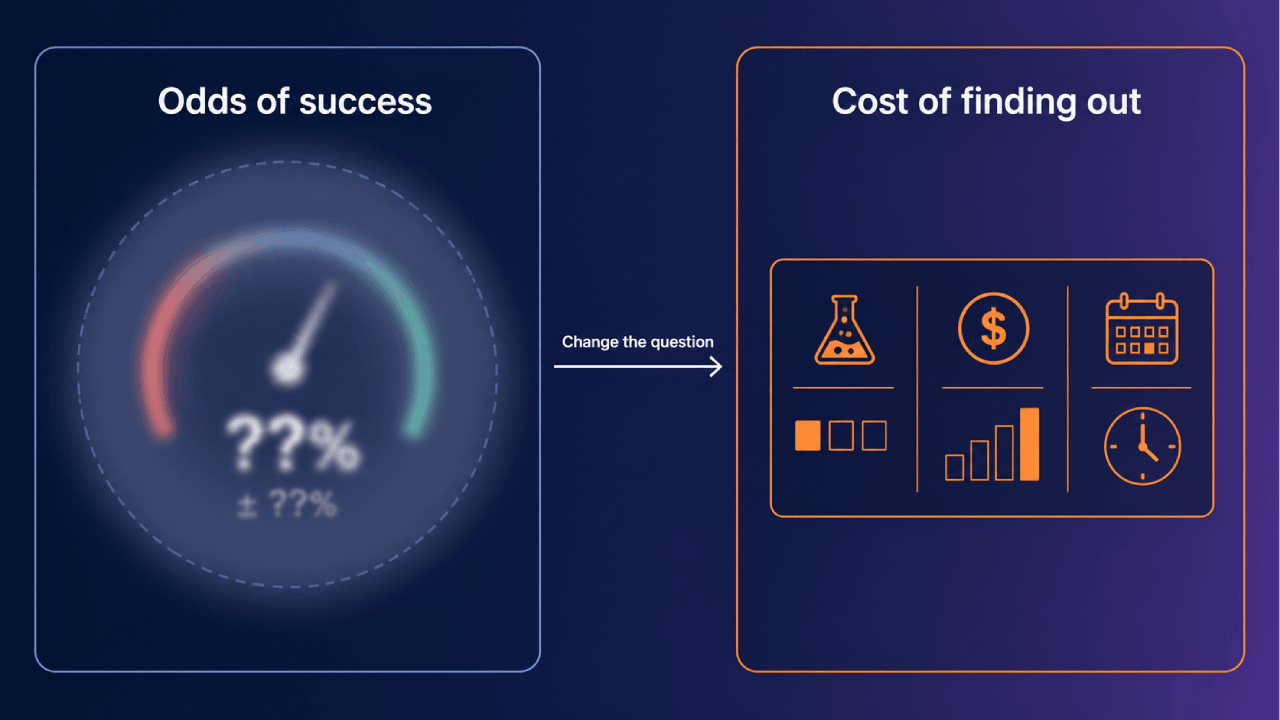
Hun oplossing is betere plannings- en beheersingsinstrumenten. Op haalbaarheid hoort een goedkoop te testen idee met een grote onzekerheid hoger te scoren dan een duur te testen idee.
De rubric zo ontwerpen dat hij niet alles afvlakt
Gebruik 3 verankerde niveaus in plaats van een schaal van 1 tot 10. Een 10-puntsschaal nodigt uit tot rekenwerk dat het onderliggende oordeel niet kan dragen.
Tversky en Kahnemans studie uit 1974 liet zien hoe ankers schattingen verschuiven. Groepen die op 10 en 65 begonnen gaven mediane schattingen van 25% en 45% voor Afrikaanse landen in de VN.
Eerlijk gezegd is dat algemeen schattingsonderzoek, en de doorvertaling is van mij. Fijnmazigere schalen laten beoordelaars vermoedelijk meer ruimte om af te drijven naar het getal dat ze het eerst zien.
Veranker elk niveau in controleerbaar bewijs
Een verankerd niveau benoemt bewijs dat een beoordelaar kan controleren, dus “redelijk haalbaar” volstaat niet. Rangschik de niveaus naar de kosten om de onzekerheid weg te nemen, niet naar de omvang ervan.
| Niveau | Wat waar moet zijn | Bewijs dat een beoordelaar kan controleren | Wat het in dit stadium betekent |
|---|---|---|---|
| Goedkoop op te lossen | Eén test neemt de belangrijkste onzekerheid weg | Een benoemde aanname, een testplan, een datum | Komt deze cyclus in aanmerking voor een test |
| Duur op te lossen | Oplossen vraagt om een bouw of een partner | Een testplan met echte kosten eraan | Vraagt om een gefaseerd budget bij selectie |
| Nog niet in te schatten | We kunnen niet zeggen wat er misgaat | Geen vergelijkbaar werk, geen test ontworpen | Terug naar de verrijking |
De klassieke review uit 1980 van gedragsverankerde schalen, van Jacobs, Kafry en Zedeck, vond dat BARS “is no better or worse than other methods when assessed on a quantitative basis.”
Diezelfde review schrijft het format wel “greater potential” toe op bruikbaarheids- en kwalitatieve criteria. Ankers leveren je dus een gedeelde interpretatie op, terwijl meetprecisie buiten bereik blijft.
Houd de assen gescheiden en de criteria beperkt
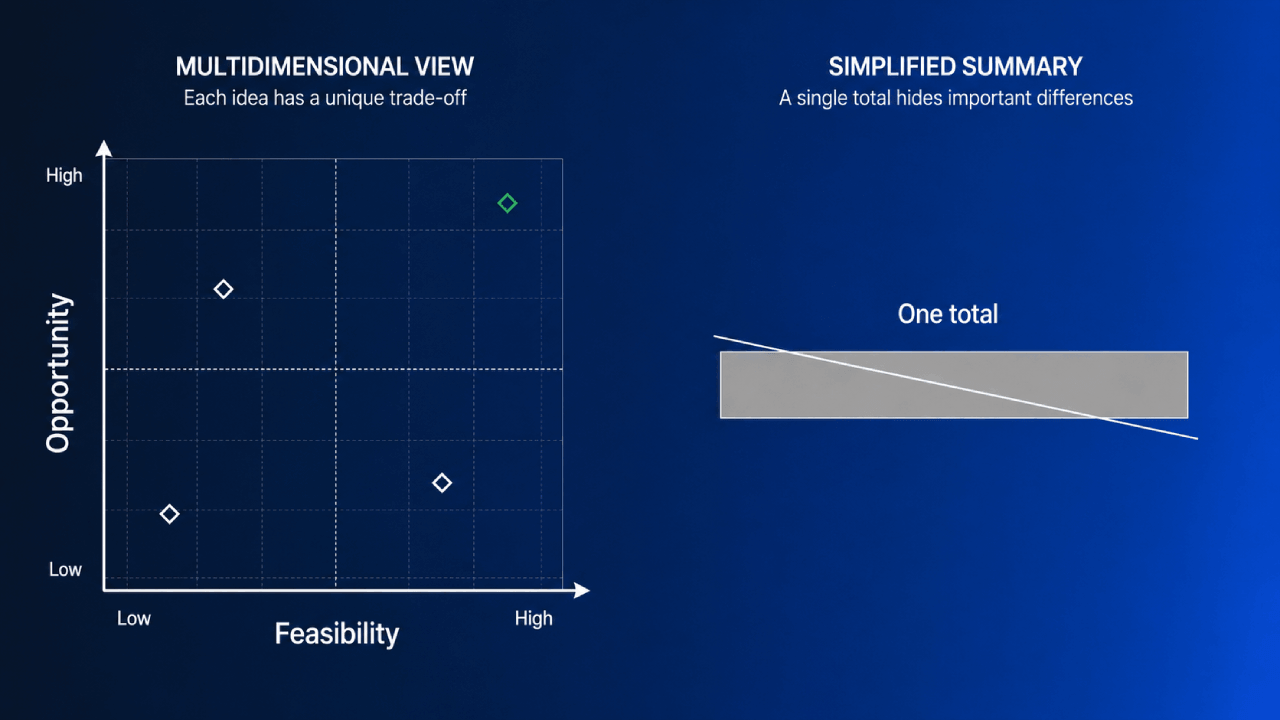
Het Institute for Manufacturing in Cambridge benadrukt kansen en haalbaarheid apart te behandelen. Houd beide uitkomsten zichtbaar, want één totaal verbergt de afweging waar de beslissing over gaat.
Thorndikes artikel uit 1920 over beoordelingsfouten rapporteert oordelen “apparently affected by a marked tendency to think of the person in general as rather good or rather inferior.”
Dat waren beoordelingen van industriële werknemers, dus de overdracht is een gevolgtrekking. Het risico op een scorecard is dat één sterke indruk beide assen kan kleuren.
De controlled convergence-richtlijn van het IfM noemt “a good target of high level criteria… around 10,” aangeboden als praktijkrichtlijn van een genoemd instituut, zonder gevalideerd plafond erachter.
Waar haalbaarheid de funnel binnenkomt
Bij de ideeënintake controleer je de harde kaders en verder niets. Een score op een idee dat niemand heeft bekeken beschrijft de indiener, niet het werk.
Haalbaarheid hoort thuis in de evaluatiestap na de verrijking, zodra iemand ernaar heeft gekeken. Dat ligt vóór elke toezegging van echt geld.
De volgorde kent vier haltes:
- Intake: alleen harde kaders, gecontroleerd en vastgelegd.
- Verrijking: de indiener en een beoordelaar onderbouwen de risicovolste aannames.
- Gescoorde beoordeling: waarde en haalbaarheid op gescheiden assen, met eventuele wegingen binnen elke as.
- Financieringsgate: beide asuitkomsten vergeleken zonder ze op te tellen, daarna de beslissing en de onderbouwing vastgelegd.
Een studie uit 2019 naar verwachte beoordeling vond dat groepen daaronder minder ideeën produceerden, 21,03 tegenover 32,95 gemiddeld.
Diezelfde groepen verkenden minder ideeëncategorieën, 11,65 tegenover 15,05. De originaliteitsscores verschilden niet significant, wat de eerlijke lezing ervan is.
Het argument gaat dus over de zoekruimte, niet over een aangetoonde daling in originaliteit. Groepen die beoordeling verwachtten produceerden minder en verkenden minder breed.
Dat laat minder kansen over voor een werkelijk origineel idee om de scorecard te bereiken.
Publiceer scorecriteria en timing in de missiebriefing, en herhaal de non-negotiables op het formulier. Verwachte beoordeling kost volume, en vaagheid kan je de ideeën kosten die ertoe doen.
Vier manieren waarop een haalbaarheidsscore misgaat
Vier faalpatronen zijn het ontwerpen waard, een smallere set dan de governance-antipatronen eromheen. Elk is een scoringsartefact dat zichzelf niet aankondigt.
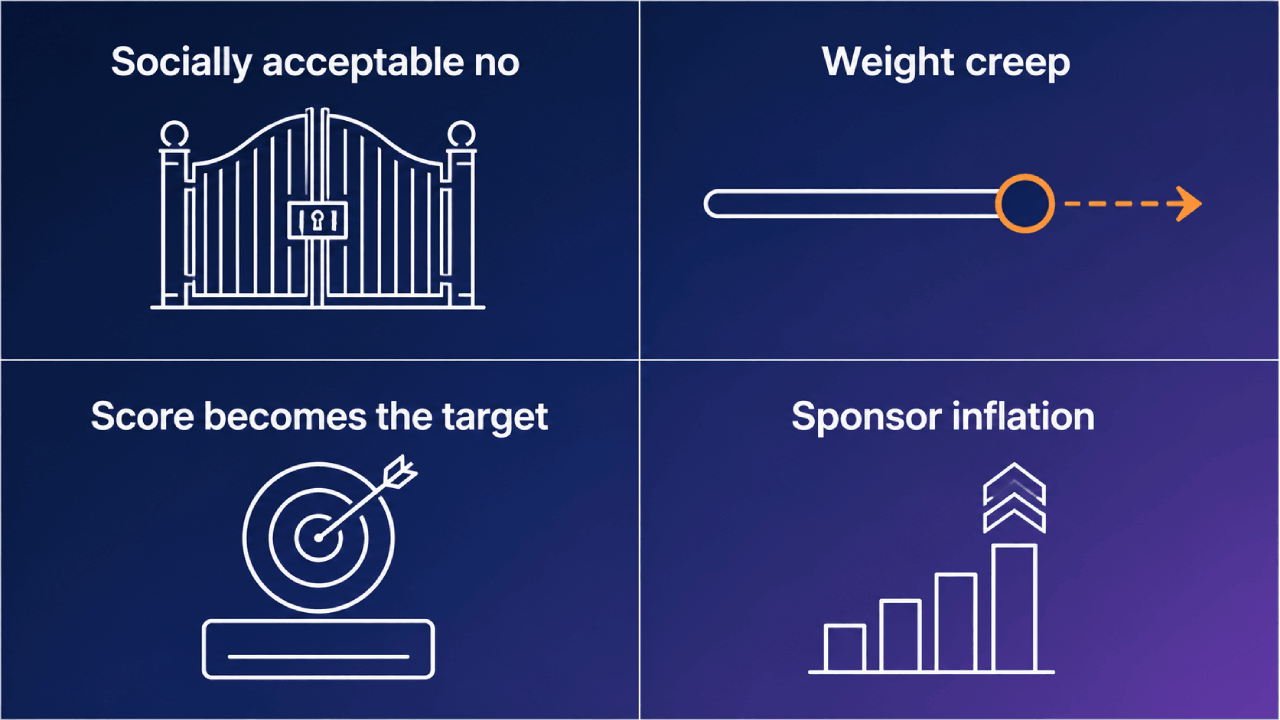
Haalbaarheid als een sociaal aanvaardbaar nee
Haalbaarheid geeft een beoordelaar een reden die onverdedigd blijft. “Nu te moeilijk” beëindigt een gesprek dat “liever niet” niet kon beëindigen.
Let op beoordelaars van wie de haalbaarheidsscores nauwer samenhangen met hun eigen werkdruk dan met het idee dat voorligt.
Het getal kan oprecht zijn, en wat het voortbracht blijft toch onzichtbaar tot iemand de ankers opschrijft.
Een verankerd niveau dwingt de beoordelaar te benoemen wat er werkelijk ontbreekt. Capaciteit volgend kwartaal is een planningsprobleem en hoort in een ander gesprek thuis.
Wegingsdrift
Haalbaarheid is het makkelijkste criterium om hardop te verdedigen, dus let op of de weging ervan oploopt. Zet een datum in de agenda om de wegingen te herzien.
De richtlijn over wegen en scoren van het IfM noemt zowel de wegingen als de scores “subjective and arbitrary,” en de methode “extremely sensitive to small changes.”
De wegingen naast de scores publiceren maakt veranderingen zichtbaar. Ziet de eerste set er verkeerd uit, gebruik het bezwaar dan om de aannames te toetsen.
De score wordt het doel
Goodharts oorspronkelijke formulering is droger dan de versie die mensen citeren: “Any observed statistical regularity will tend to collapse once pressure is placed upon it for control purposes.”
De bekende formulering “when a measure becomes a target” is Marilyn Stratherns herformulering uit 1997, en die verdient een correcte toeschrijving.
Zodra indieners de rubric doorhebben, kunnen zij ernaartoe schrijven. Dat is beheersbaar wanneer de rubric bewijs beloont, en funest wanneer hij bijvoeglijke naamwoorden beloont.
Sponsorinflatie
Sponsoranciënniteit is het toetsen waard tegen de scores, want weinig beoordelaars geven graag een tweetje aan het voorstel van een directeur. Vergelijk scores per sponsorniveau.
Vraag beoordelaars onafhankelijk te scoren vóór de discussie, of maak de eerste ronde blind. Dat beschermt het eerste getal dat wordt opgeschreven, al vertraagt het de sessie.
Een tijdgestempeld verslag maakt veranderingen in wegingen en scores beter controleerbaar. Daar verdient het platform waarin je scoort zijn plek.
Zet de kaders op papier voordat je ze in een score zet
De rubric is een beleidsdocument, of je hem nu zo noemt of niet. Hij vertelt mensen welk soort ambitie het contact met de funnel overleeft.
Vier veranderingen zijn het eerst waard:
- Haal de must-meetkaders eruit en beperk de lijst tot vijf.
- Scoor de kosten van het wegnemen van de onzekerheid, niet de kans op succes.
- Veranker haalbaarheid op drie niveaus, met waarde gescoord op een aparte as.
- Pas haalbaarheid toe na de verrijking, en publiceer de rubric, de wegingen en het verslag.
AI hoort thuis in het opstellen en het controleren. Het kan scorecardcriteria voorstellen vanuit je strategie en scoring markeren die tussen beoordelaars uiteenloopt.
Begin met de must-meetlijst en beperk hem vóór de volgende scoreronde. De rest van de rubric wordt eenvoudiger zodra die kolom op zichzelf staat.
Ons e-book over ideeëvaluatie en governance doorloopt dezelfde pijplijn van intake tot portfolio. Het gaat dieper op verrijking en scoring in dan één artikel kan.
Of plan een demo om te zien hoe Accept Mission omgaat met scorecards, gewogen criteria en de tijdgestempelde verslagen die scoringsdrift zichtbaar maken.
Get Social